実写の車内写真に生成AIの人物を座らせる ~ 画像生成AI実験メモ ⑨
前回は、SDXLモデルでも、ADetailer・OpenPose・Depthが有効かどうかを、実際に画像を生成しながら確認してみました。
 https://try-widely.com/stable-diffusion_sdxl-tools/
結果としては、ADetailerやOpenPose、Depthのそれぞれの得意分野を理解して使えば、SDXLでも十分に有用であることが確認できました。これで、人物についてはかなりのところまで期待する生成ができるようになったんじゃないかと思います。
が、それでもなお再現が難しい難問が残っています。
それは、リアルな背景、です。
本記事に掲載している人物画像は、すべて生成AIにより作成したものであり、特定の実在人物をモデルにしたものではありません。
列車に乗せたい!
屋外では草原や公園、屋内ではリビングやキッチンなど、プロンプトで指定するだけで、それなりに日本人と相性のいい、というか違和感のない背景が生成されます。
ところが、です。
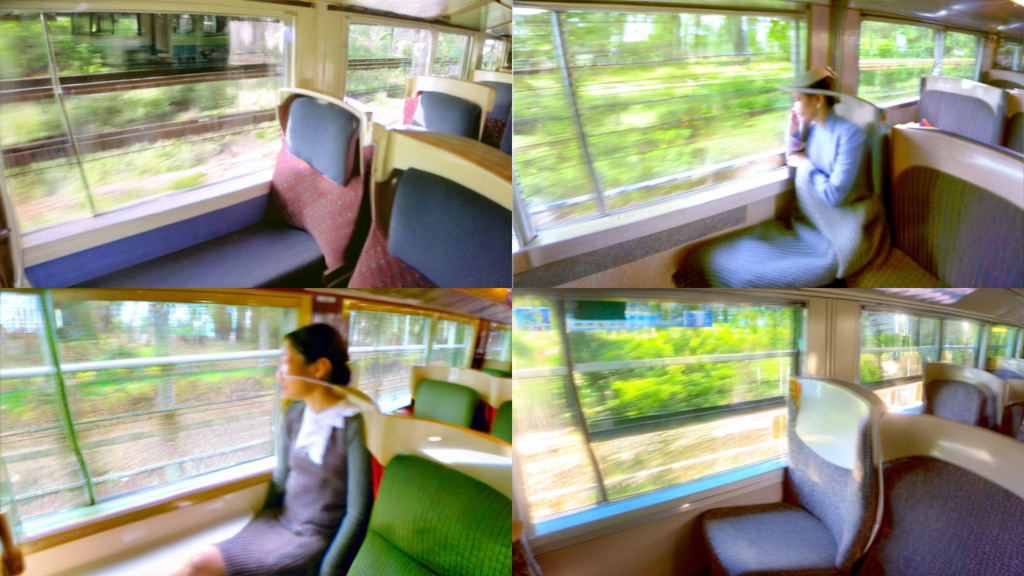
私の趣味である鉄道を題材にすると、「これ、どこの列車なんだ…」という画像しか生成できないんですね。
例えば、こんな感じ。
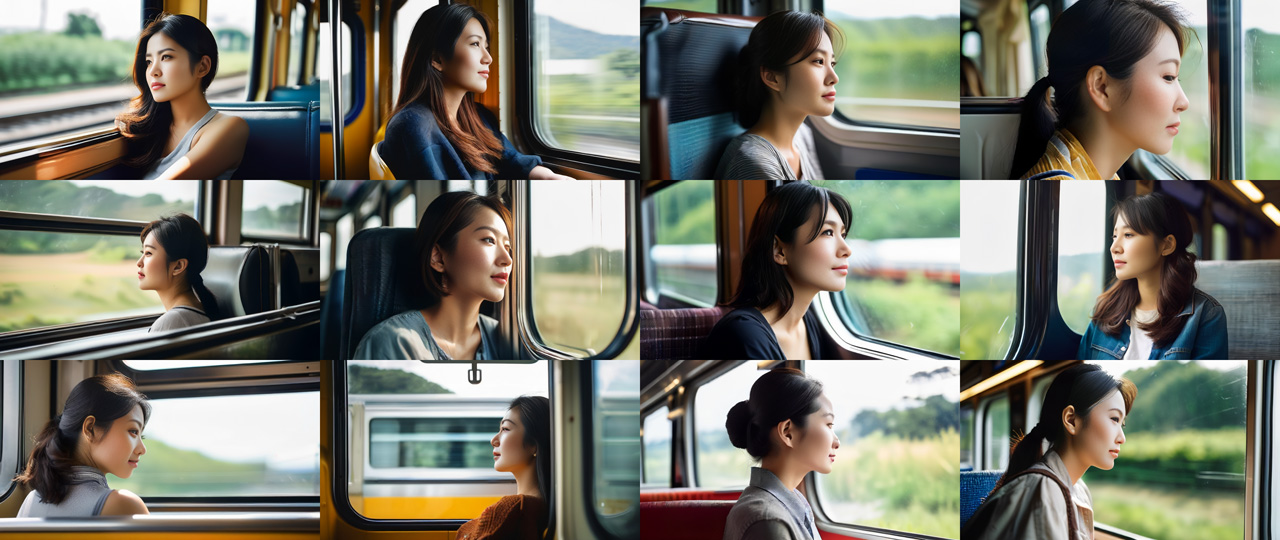
鉄道車両だということはわかるんですが、なんか、日本の鉄道っぽくないんですよね。
いかにも生成AIで作りました、という感じの画像です。
クロスシートで頬杖をつきながら…
勝手なイメージですが、窓べりに肘をつき、頬杖をついて車窓を眺める様子が、あまり鉄分の濃くない人のスタイルなんじゃないかな、と。
というわけで、漠然としたイメージをプロンプトに落とし込んで、12枚を生成してみました。
prompt
a woman sitting by the window in a passenger train carriage, seated on a cross seat,
supporting her face with her right hand, resting her cheek lightly on her palm,
her head tilted slightly into her hand, elbow resting on the armrest,
leaning slightly toward the window, relaxed seated pose,
looking outside, side view, soft natural daylight,
realistic detailed train interior
Negative prompt
multiple people, standing, extra arms, extra hands, extra legs, malformed hands,
bad anatomy, twisted body, fused legs, disconnected limbs, blurry, lowres, cropped body
パラメータは、
・Model:sd_xl_base_1.0.safetensors
・Sampler:DPM++ 2M SDE
・Schedule type:Karras
・Sampring steps:32
・CFG Scale:6
・Seed:-1
・サイズ(Width x Height):1024 x 576
としています。
まずは、プロンプトだけでどれくらい頬杖をついた画像が出るか、という観点から。
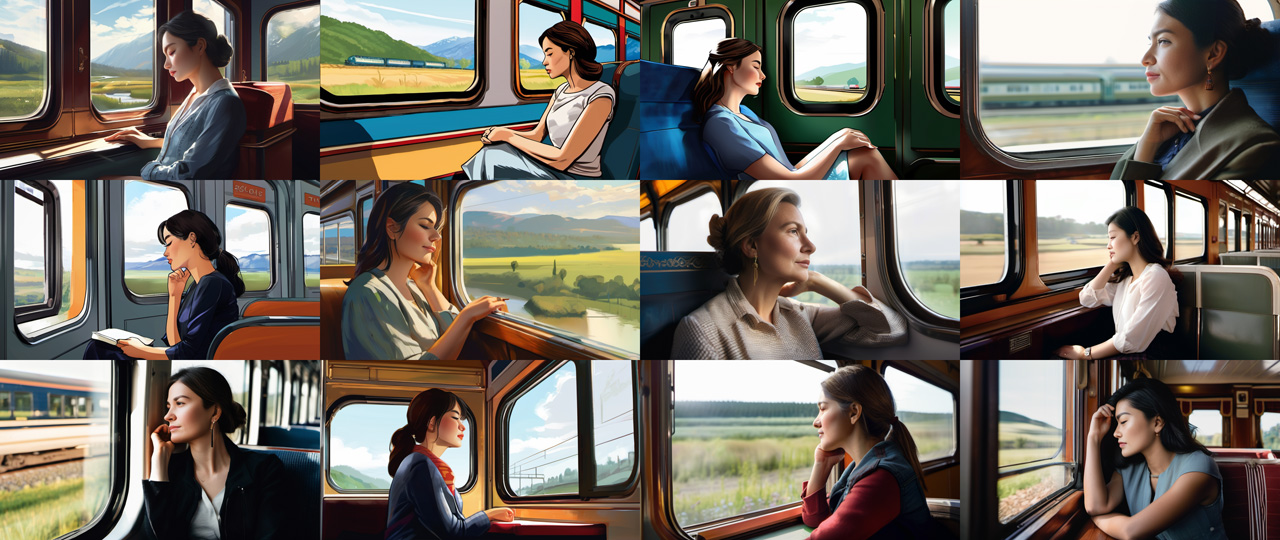
片手が上がっているといえるのは、12枚中8枚。そのうち、頬のあたりに手を添えているのは、6枚ですね。
肘が窓際にかかっているは12枚中4枚。イメージ通りかな、というのは、中段右端の1枚くらいですかね。
プロンプトだけではなかなか思うように生成できない、というのが現実ですね。というわけで、OpenPoseかDepthかを使用することで、同じポーズの画像を効率的に生成できないかと、そのモデルを見つけるべく、何回か生成していると、理想的な1枚が出てきました。それがこちら。
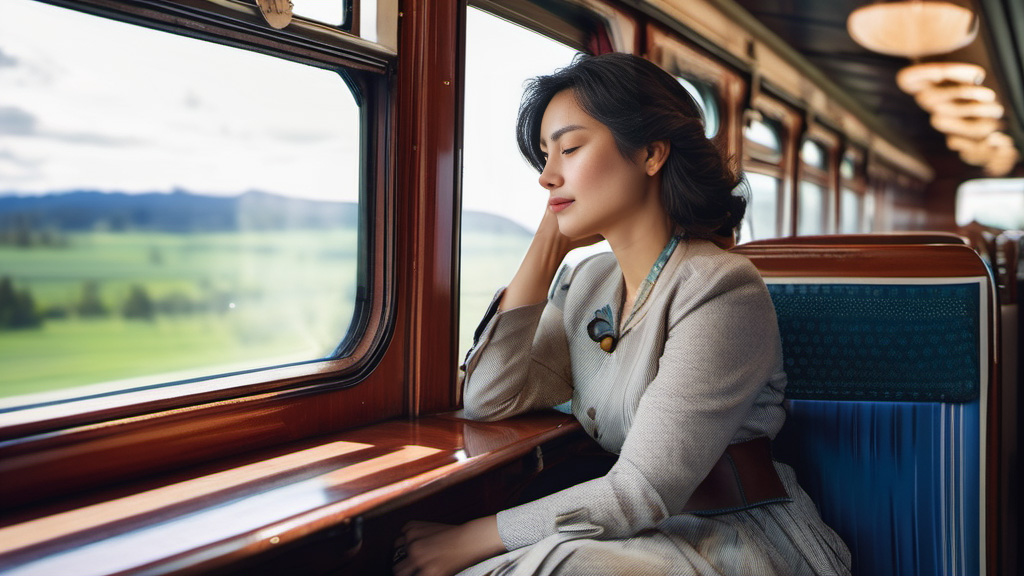
これを骨格モデルとしてOpenPoseを、陰影画像のベースとしてDepthの両方を試してみたいと思います。
OpenPoseで生成
SDXLでのOpenPoseの使用については、こちらをご覧ください。
Preprocessorには dw_openpose_full、Modelには、contorlnet-openpose-sdexlを設定し、骨格モデルを抽出したのがこの画面です。
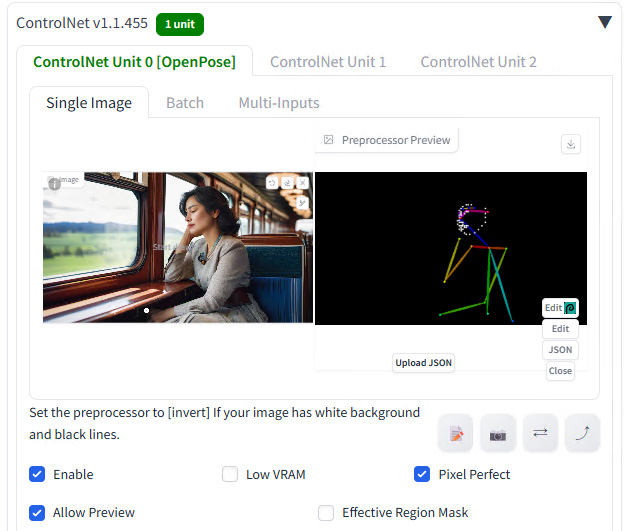
これで12枚を生成しました。
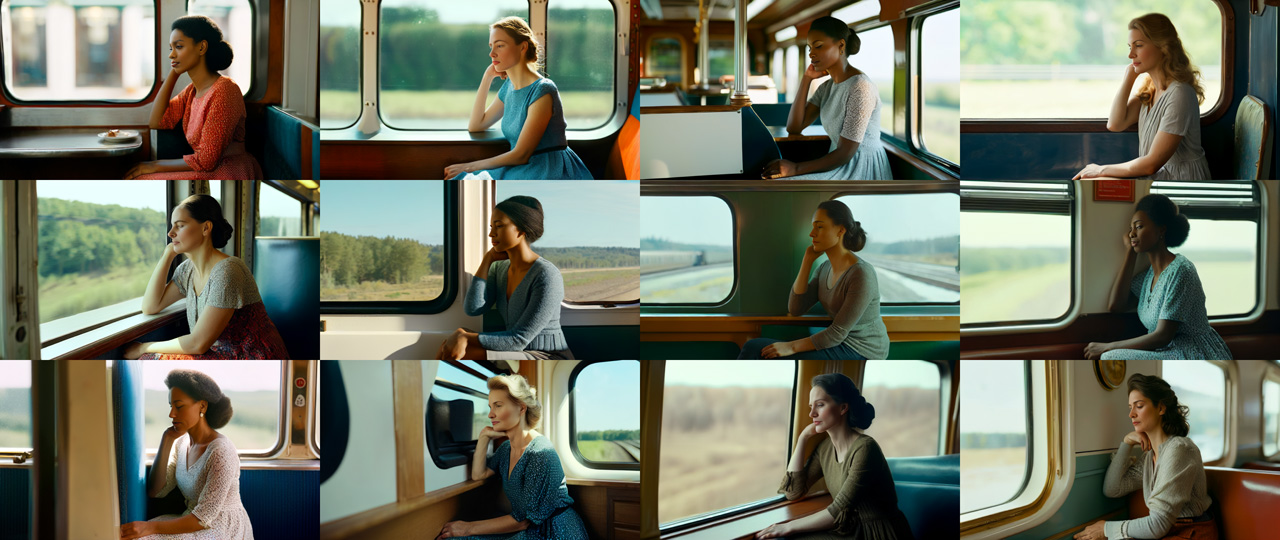
さすがは骨格モデルが同じOpenPose…ではあるんですが、あれれ?ですよね。
ポーズは12枚共に同じなんですが、窓に対する角度が違うものがあったり、肘が窓べりに接していない(窓べりに肘が乗っていない)ものも多数あったりします。
こういう時、出番になるのがDepthとなるでしょうか。
Depthで生成
SDXLでのDepthについても、上記リンクから見て頂きたいのですが、Preprocessorには depth_midas、Modelには、diffusers_xl_depth_full を設定し、陰影の画像を抽出したのがこの画面です。
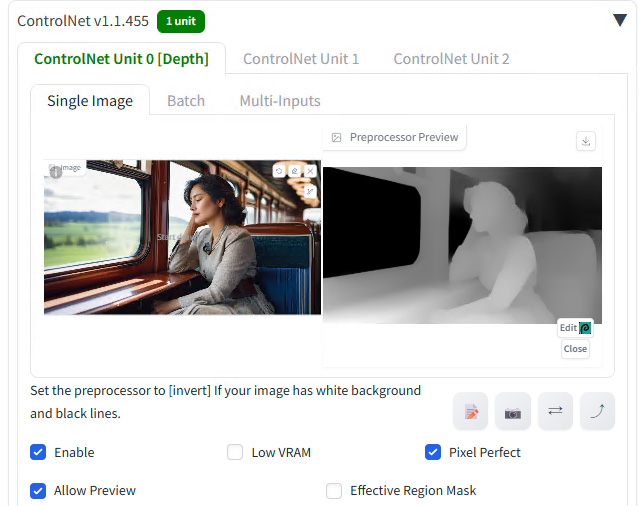
身体の向き、腕の位置だけでなく、車両の壁面、窓の位置まで深度として現れますから、期待できます。
これで同じく12枚を生成。
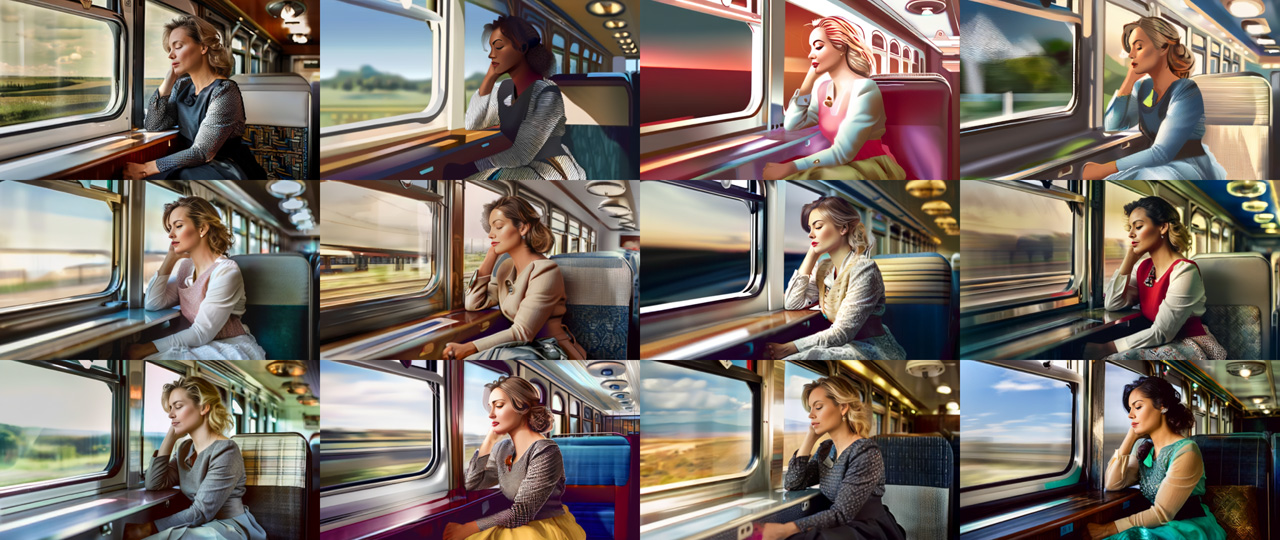
イラストっぽい感じがするのはさておき、金太郎飴的な「予想外の無い」つまらなさがありますね。。
なにより、プロンプトだけで生成した、ベース画像と同じなので仕方がないんですが、窓際のひじ掛け部分が幅広過ぎるんですね。小さなカウンターのようになってます。
Depthで、この幅を狭めるのはほぼ無理。ですので、プロンプトで期待する画像を生成すべく、ひたすら出力しまくるか、OpenPoseを併用してプロンプトを駆使して期待する画像を生成するか。悩みどころです。
でも、どちらにしても「日本の列車」に程遠いのが現状。
そこで、試してみたのが、Cannyです。
※最終的にはCannyを使用しませんでした。ちょっと回り道になりますので結論を急ぎたい方は、「Inpaintの活用」からお読みください。
Cannyとは?
CannyはControlNetの機能の一つで、ベース画像の輪郭線・エッジを取得し、生成に反映させるということが出来ます。
つまりは、日本の列車の座席の写真があれば、それに近い画像が生成できるのでは?と期待できます。
とはいえ、そんなに都合のいい写真など無く(ネット上を探せば無くはないんですが、生成の素材にするには著作権等の問題もありますから、自身で撮影したものを使用したいところです)、しばらく悩んだ結果、昨年秋に山梨へと旅行に出かけた時に撮影した動画に映ってるんじゃないか、と。
胸に着けたアクションカメラで撮影しながら、甲府駅から特急「あずさ」に乗車した際の画像から撮ったキャプチャ画像です。
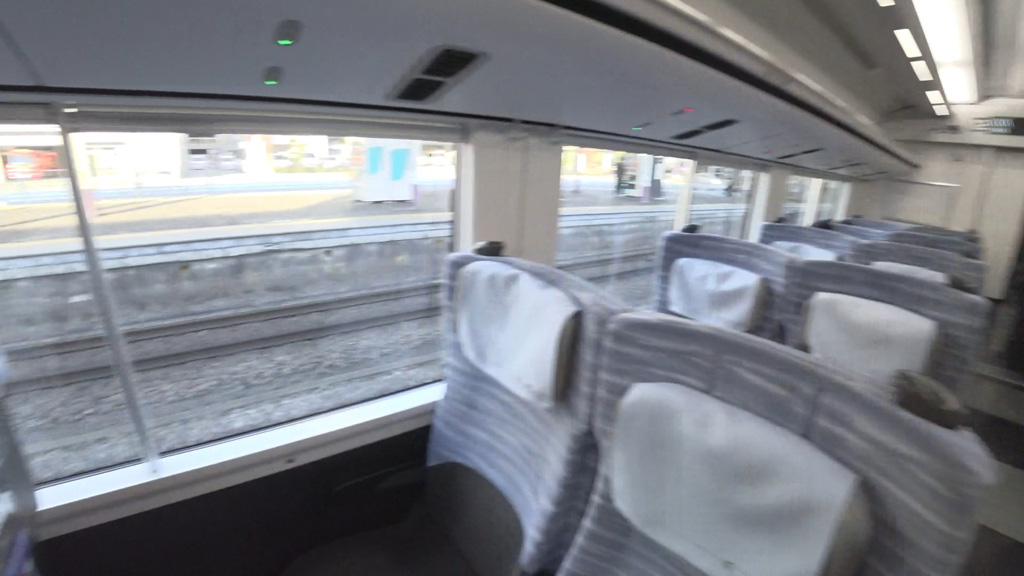
E353系ですね。
動画からのキャプチャなのでブレているのがちょっと問題かと思いますが、まずはこれを使用してみたいと思います。
OpenPoseの骨格モデルと完全一致させる必要は無さそうで、大まかな視点、人物と画像の大まかな位置関係があっていれば、何とかなりそうです。
もちろん、今回は肘をつきたいので、ベース画像にも肘を置ける場所があること、が重要ですね。
まずは下準備
Photoshopを使って、トリミングをします。
OpenPoseで使用するモデルの位置に、座席が合うように画像を切り抜きます。もちろん、ドット単位で厳密にする必要は無く、だいたいの感じです。
それと、ソフトでのブレ補正をかけてみました。
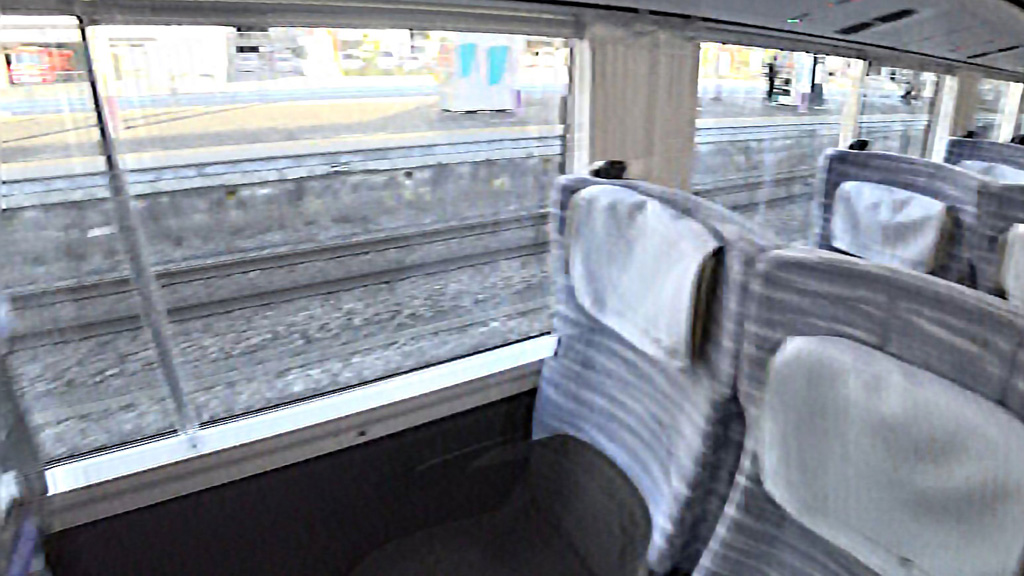
これをベースの画像とします。
初めてCannyを使用しますので、モデルの準備も必要です。
Preprocessorは canny を選ぶのですが、Modelは準備していないので、Noneとなっています。
controlnet-canny-sdxl-1.0を使用するのですが、このダウンロードファイル名が diffusion_pytorch_model.safetensors です。これ、ひっかけポイントですね。SDXLのOpenPoseのファイル名が同じなんです。ですが、同じものではありません。
Hugging Face のリンクがこちら。
https://huggingface.co/xinsir/controlnet-canny-sdxl-1.0
「Files and Versions」タブにあるファイル一覧から、diffusion_pytorch_model.safetensors を選び、Downloadアイコン(↓)を押します。
ダウンロードが終われば、controlnet-canny-sdxl-1.0.safetensors とリネームしておくことをお勧めします。格納するフォルダが、OpenPoseのモデルを格納する場所と同じですからね。リネームしないと上書きになってしまいます。
stable-diffusion-webui
└─ extensions
   └─ sd-webui-controlnet
      └─ models
         └─ controlnet-canny-sdxl-1.0.safetensors
ControlNet Unit 0 にはOpenPoseを、Unit 1 にCanny を設定します。
PreprocessorとModelの間にある Run Preprocessorのアイコンをクリックすると、輪郭線が取得できます。
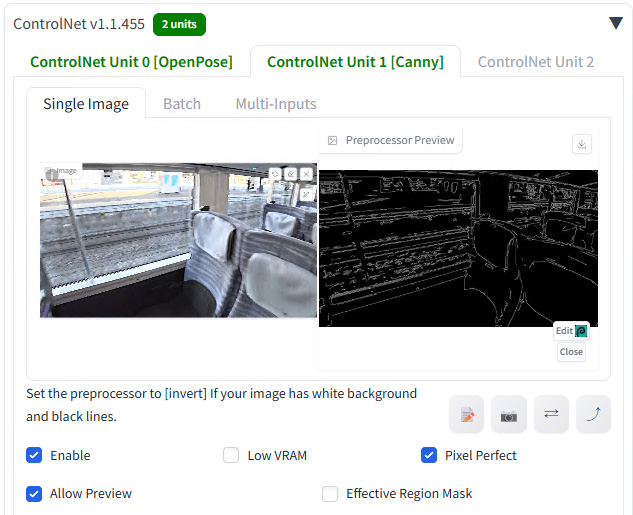
ControlNetはUnit0~Unit2に異なる機能を割り当てることが出来るんですね。もちろん、競合する機能を割り当てると期待する画像に近付くことはできませんが、上手くバランスを取れれば、面白い結果を生み出します。
今回は、Unit0にOpenPoseを指定していますが、生成の最後までOpenPoseを効かせるのではなく、End(Ending Control Step)を 0.8 としました。
Unit1のCannyは、Weight、Endをともに0.55としています。
OpenPose + Canny で生成
これで、4枚を生成。
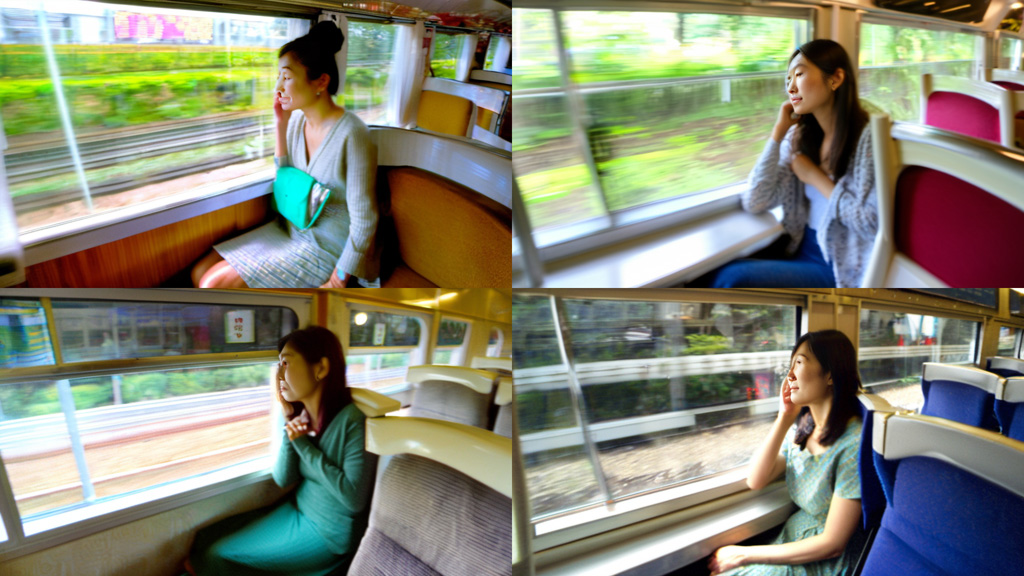
確かに、座席の配置などは、ベースモデルのままです。
顔の崩れにゾッとしたんですが、そのあたりは後ほどADetailerで対応するとして、まずは、ポーズと座席の関係を見てください。
肘は曲げているものの、うまく肘をついているものがないですね。それと、左側の2枚は肘が身体についてしまってます。
なので、OpenPoseのWeightを強めて、1.0を1.1に、同じくOpenPoseのEndも、0.8から0.9への少し上げます。
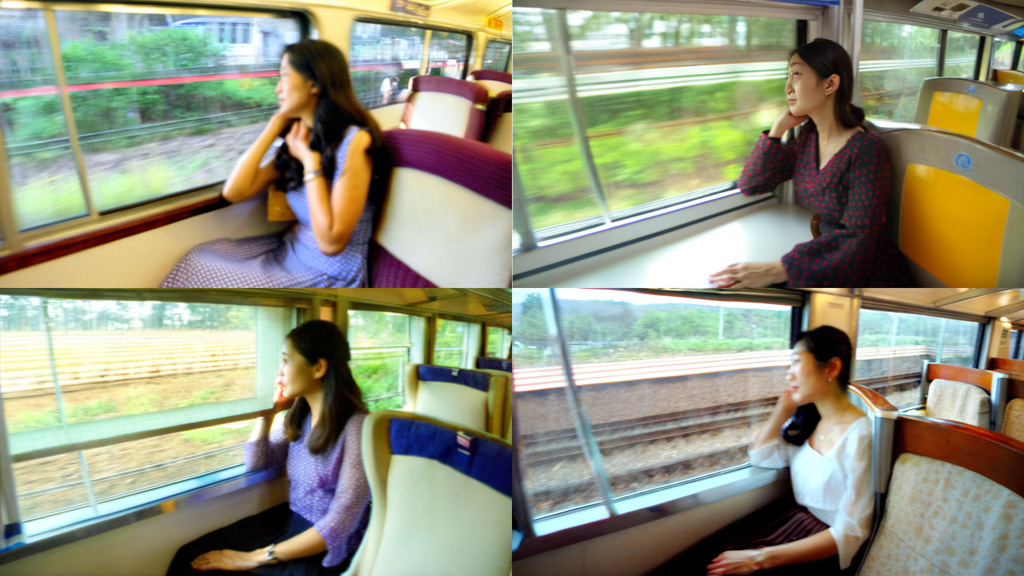
OpenPoseを強めることで、身体と肘の位置関係は強化された感じがします。
面白いのが、Canny側のWeightを強めるとどうなるのか、というところです。0.55から0.75へと上げると、
Canny素材の「座席」がOpenPoseの「人物」に勝ってしまって、座席しか描かれない、ということが起こるんです。
という感じで、Cannyのweightは0.55くらいが上限なのかな、と、気付けたところで、「それにしても、E353系のシートとは似ても似つかない色だよな」と。
で、プロンプトにシートの色の設定を追加したり、いろいろやってみたんですが、どう頑張ってもE353系の室内の雰囲気には近づけず。
やっぱり「輪郭(エッジ)重視」のCannyで再現するのは無理があるな、と断念した次第です。
Inpaintの活用
そこで、「車内の写真はそのまま使えばいいのでは?」と、ベース画像にE353系の車内写真を使用し、そこにOpenPoseでの人物を重ねてみようと、やってみました。
使用するのは、これまでやってきた「txt2img」ではなく、その隣のタブ「img2img」です。
既存画像を基にした画像生成で、これまでは1枚の顔写真を、ちょっと表情を変えさせたりとか、LoRAでの学習を固着化させないために衣装や背景を変えたりするのに使用してきましたが、背景として画像を使用する、という使い方は初めてです。
さて、どうなることやら。
使用するE353系の車内写真は、先ほどまでのとは別で、前日の夜に東京駅から乗車した「かいじ」のものです。こちらの方がブレがなくて、いいかな、と。さすがに窓への反射は表現できないでしょうが、全体がブレた画像よりは良さげです。
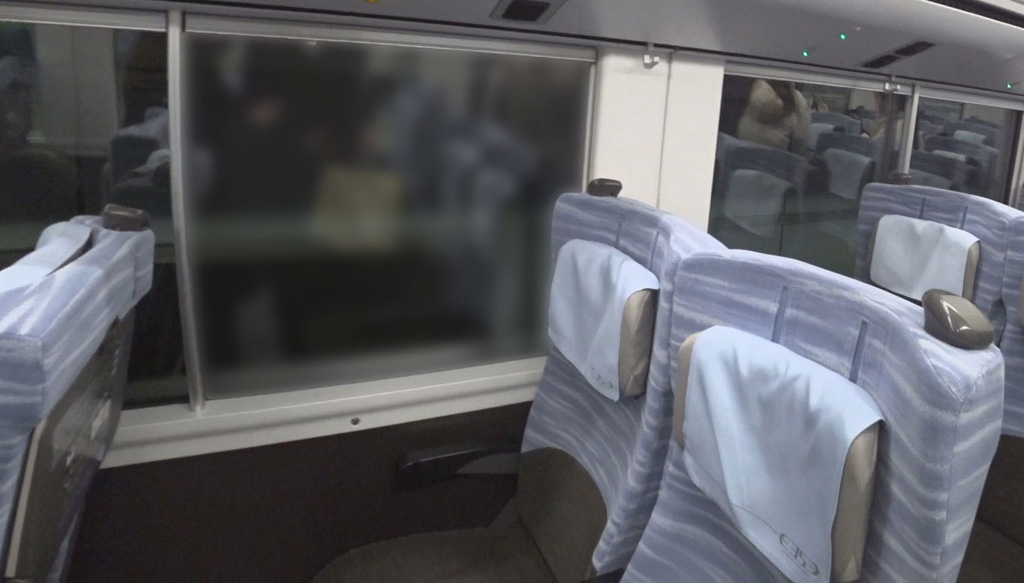
ちなみに、奥に見える窓はぼかしてます。私が写ってますので(笑)
まずは、img2imgの「Generasion」タブにある「Inpaint」タブを選び、車内の画像をドラッグ&ドロップ。
これが絶対というパラメータ設定は無いんですが、
・Resize mode:Just resize
・Mask blue:8
・Mask mode:Inpaint masked (←これは必要)
・Masked content:latent noise
・Inpaint area:Only masked (←これも必要)
・Only masked padding, pixels:32
・Denoising strength:0.75
あたりでしょうか。
それから、設定した画像にマスクをかけます。
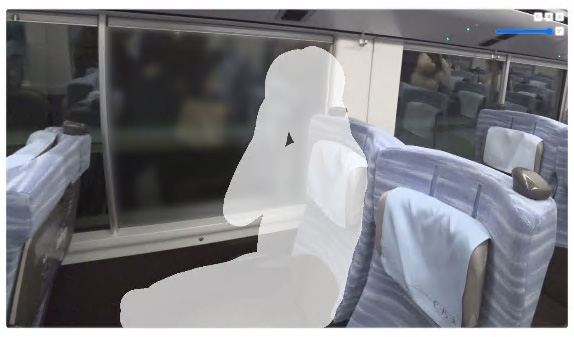
こんな感じに。
もっとも、これは結果論で、最初はざっくりと大きめにマスクをして、OpenPoseの設定を加えた状態で何枚か生成し、その画像を「元画像」としてマスクを作成。こんな感じですね。
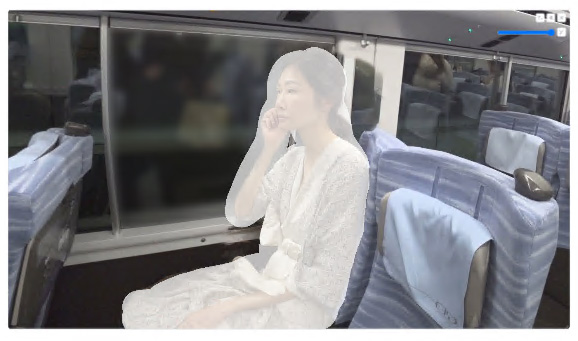
それから元画像を車内だけの写真に差し替える、という方法を使いました。
プロンプトは、しっかり目に記載してます。
prompt
RAW photo, photorealistic, realistic photography,
a Japanese woman sitting naturally in the window-side seat of a Japanese limited express train,
relaxed seated pose,
slightly leaning toward the window,
supporting her face with one hand,
resting her cheek lightly on her hand,
looking out the window,
three-quarter side view,
natural interaction with the train seat,
her arm resting naturally,
soft natural daylight,
realistic proportions,
detailed face,
sharp focus
Negative prompt
illustration, anime, manga, drawing, painting, cartoon, CGI, render,
worst quality, low quality, blurry, soft focus, hazy, motion blur,
bad anatomy, bad hands, malformed hands, extra hands, extra arms,
extra fingers, fused fingers, missing fingers,
deformed limbs, distorted face, unnatural pose, floating arm, floating elbow
で、このマスクを前述くらいに適切に設定してやると…。
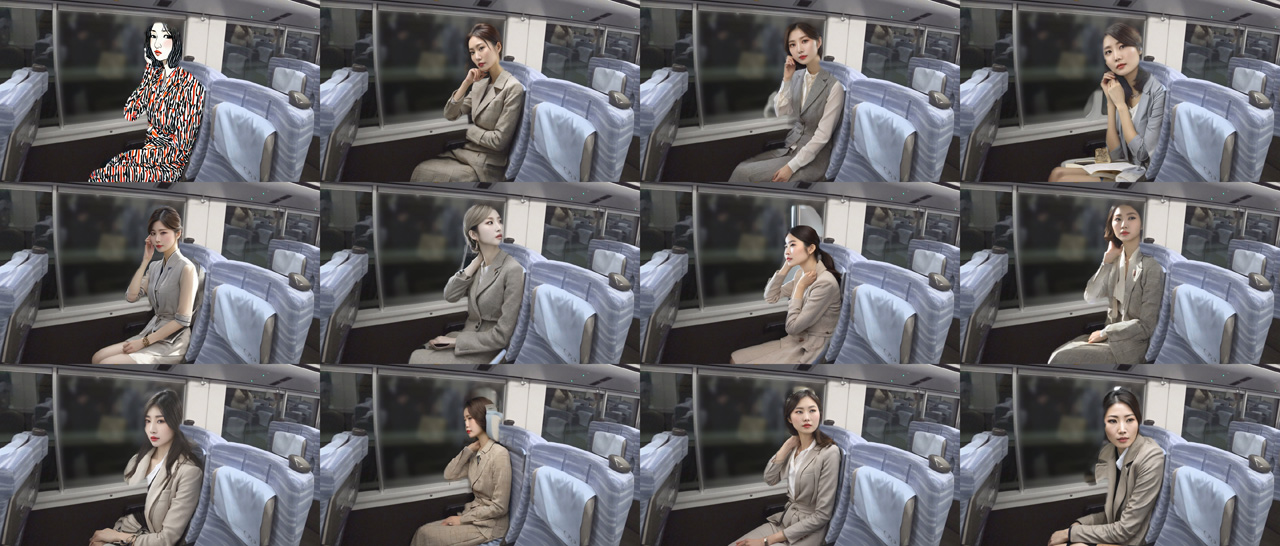
OpenPoseを使わなくても、これくらいの出来になるんですね。逆にこれには驚きでした。
※A1111の環境を新しく作成してから、1枚目がnoisyな画像になるのは、理由がよく判ってません。対策が必要なんですけど。。
OpenPoseの併用
マスクで、右手の位置を作ってやって、プロンプトにも「supporting her face with one hand, resting her cheek lightly on her hand,」なんて記載すると、いい感じで生成してくれたんですが、この成功割合を高めるには、OpenPoseなどのControlNetの活用は有効です。
最初に使用した骨格モデル用画像をそのまま使用するんですが、今回使用するベース画像に合わせるよう、全体を少しだけ左にずらし、右肘の位置をやや左上に寄せました。
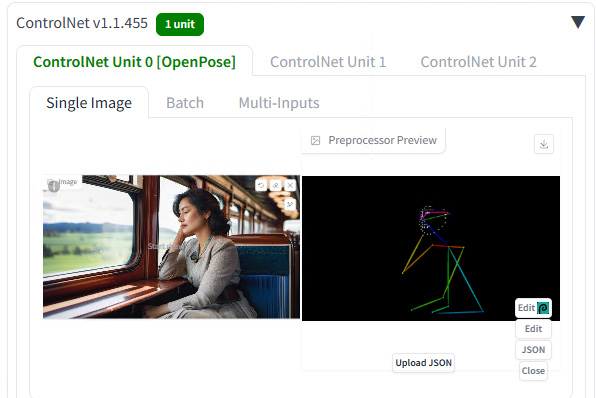
なので、元の画像と骨格モデルが少しだけ違って見えると思います。
ControlNet側のパラメータは、最初に上げたものと同じです。
が、あれ?と思ったのが、img2imgだと、標準ではControlNetの元画像を選択できないんですね。「Upload independent control image」をONにする必要があります。
txt2imgと違って、img2imgは、ControlNetの元画像も、img2imgの元画像を共用するのがデフォルトのようです。
で、生成したのがこちら。同じく12枚です。
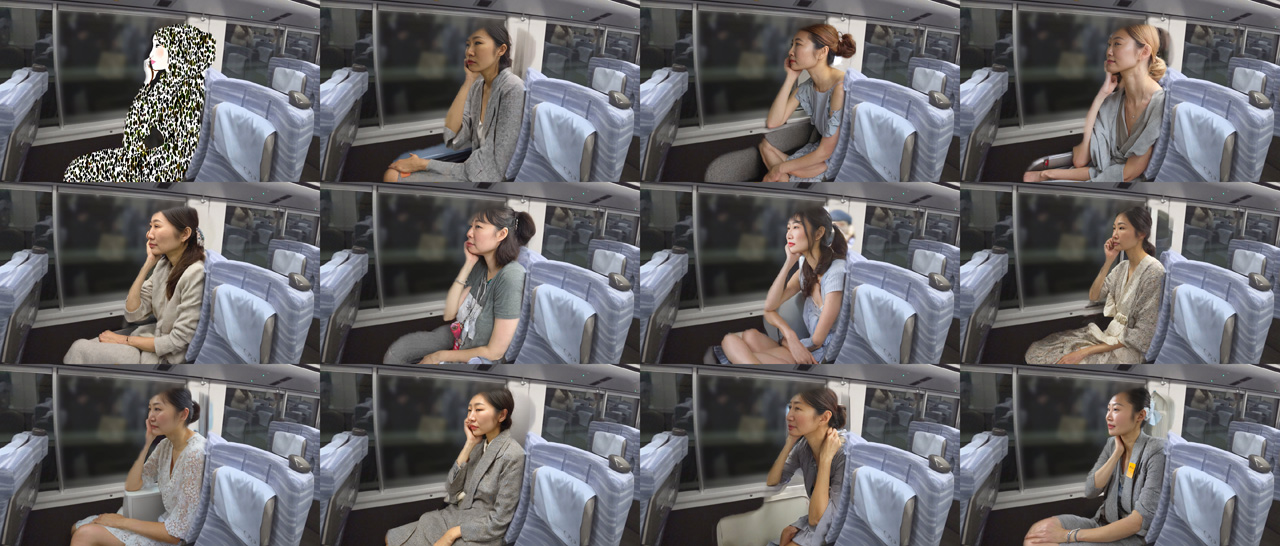
さすがに、全ての画像で右肘を立てています。左手が微妙なものもありますが、OpenPoseを使用しないときよりは意図した画像の生成割合が大きいのではないでしょうか。
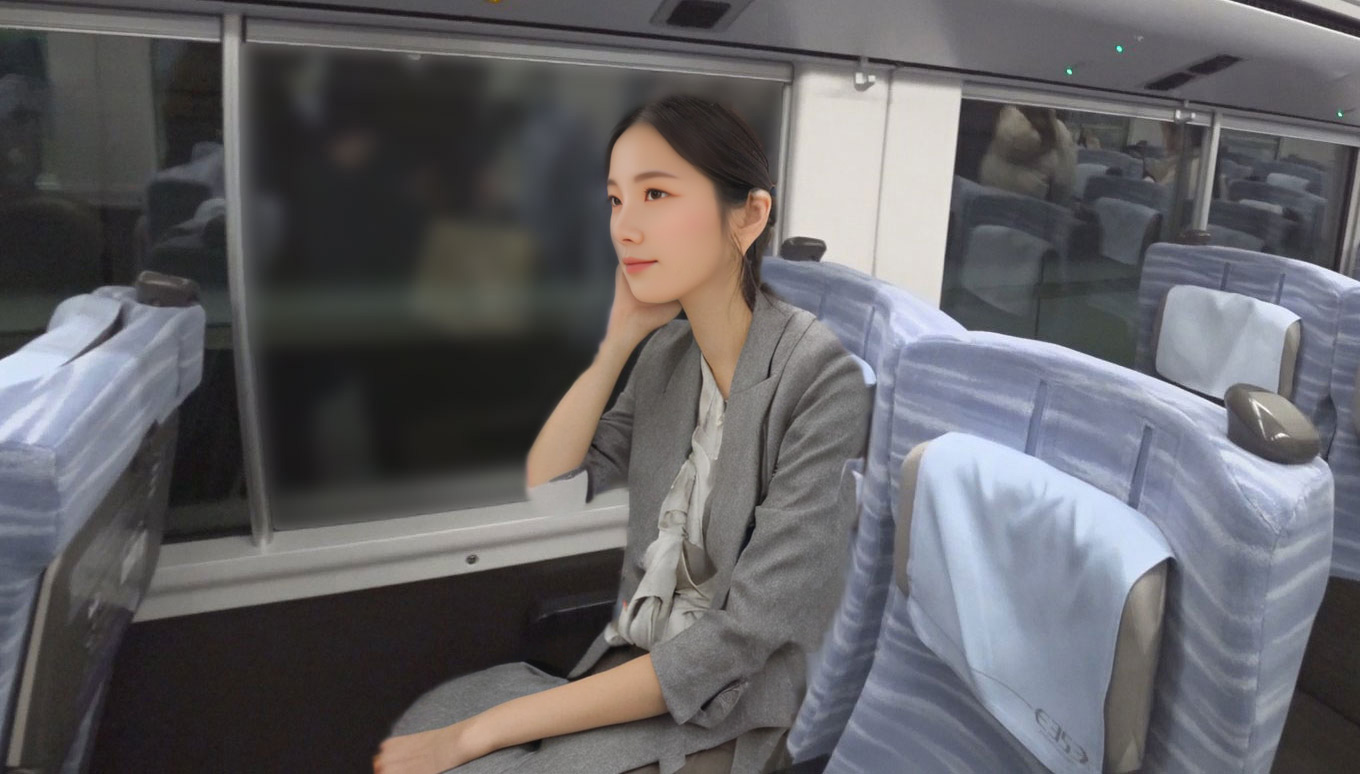
後は、LoRAを適用したり、ADetailerで顔補正したりして、今回の完成画像としたのがこちら。
自然な感じになったのではないでしょうか。
ベスト、とするにはまだまだ手を入れたい部分はありますが、元となる画像さえあれば、日本の鉄道車両のシートに座る画像というのも生成できる、という事例になったかと思います。
今回は、すべてを生成AIに任せるのではなく、実写を活かしながら必要な部分だけを生成する、というこれまでにない手法を取り入れて、期待通りの成果を得られたわけですが、これがベストな解というわけではありません。
OpenPose、Depth、Canny、Inpaintにはそれぞれ得意分野があり、「どれが一番優れているか」ではなく、「何をしたいかによって使い分ける」ことが重要なのだと思います。
どう頑張っても、既存モデルだけでE353系の車内は生成できないでしょうし、これはこれでアリだな、と思いました。これまでの旅行で撮った写真を活用する、ということも出来そうですし、リアルとAIの融合も面白いものだと思います。
Stable Diffusionの環境構築からLoRA作成、SDXLでの検証までの記事一覧は、以下のまとめページに整理しています。